AI에게 원하는 기능을 설명하면 코드를 작성하고, 오류를 수정하고, 웹이나 앱까지 만들어주는 시대입니다.
바이브 코딩(Vibe Coding)을 활용하면 모든 코드를 직접 작성하지 않아도
AI와 대화하며 서비스를 빠르게 구현할 수 있습니다.
그런데 개발이 끝난 뒤에는 한 가지 질문이 남습니다.
AI로 만든 서비스가 실제 사용자에게도 제대로 작동하는지는 누가 확인할까요?
AI에게 코드를 다시 검토하게 하고 테스트 코드를 작성하게 할 수도 있습니다.
하지만 코드에 문제가 없는지 확인하는 것과
실제 사용자가 서비스를 문제없이 이용할 수 있는지 확인하는 것은 다른 검증입니다.
바이브 코딩, 개발 방식이 달라지고 있습니다
AI를 활용한 개발은 빠르게 확산되고 있습니다.
2025 Stack Overflow Developer Survey에 따르면
응답자의 84%가 개발 과정에서 AI 도구를 사용하고 있거나 사용할 계획이라고 답했습니다.
반면 AI가 생성한 결과의 정확성을 신뢰한다는 응답은 33%, 신뢰하지 않는다는 응답은 46%였습니다.
또한 66%는 AI 도구를 사용하면서 겪는 어려움으로 '거의 맞지만 완전히 맞지는 않는 결과'를 꼽았습니다.
AI 개발 관련 조사 | 응답 |
|---|---|
AI 도구를 사용하거나 사용할 계획 | 84% |
AI 결과의 정확성을 신뢰 | 33% |
AI 결과의 정확성을 불신 | 46% |
'거의 맞지만 완전히 맞지 않는 결과'를 경험 | 66% |
출처: Stack Overflow Developer Survey 2025
즉, AI를 활용해 개발하는 것과 AI가 만든 결과를 그대로 신뢰하는 것은 별개의 문제입니다.
AI가 만든 코드는 AI가 다시 테스트하면 끝일까?
AI는 코드 생성뿐 아니라 코드 리뷰, 오류 탐색, 테스트 코드 작성 등 다양한 검증 과정에도 활용할 수 있습니다.
하지만 실제 사용자는 코드를 보지 않습니다.
사용자는 버튼을 누르고, 정보를 입력하고, 화면을 이동한 뒤 원하는 결과가 나오는지를 경험합니다.
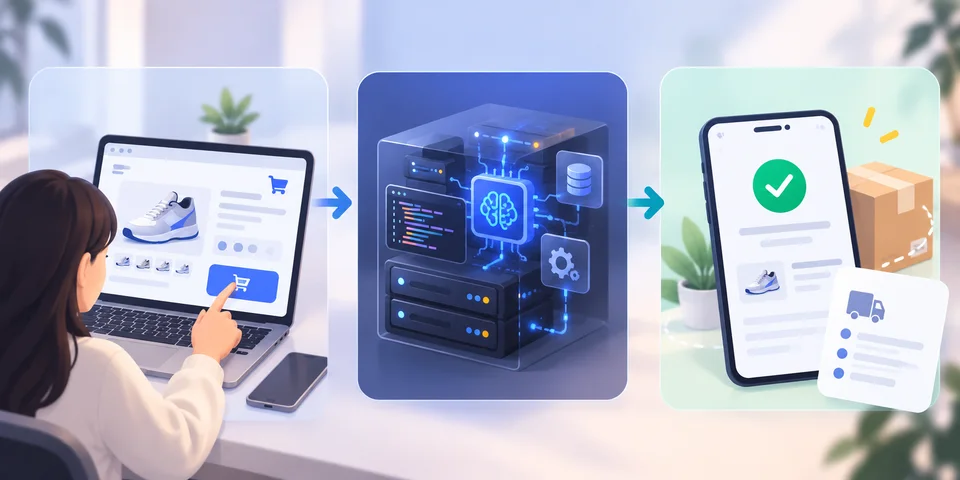
예를 들어 쇼핑몰에서 결제 버튼을 누른다고 생각해보겠습니다.
INPUT
사용자가 상품을 선택하고 결제 버튼을 누른다.
↓
BLACK BOX
내부 코드와 시스템이 요청을 처리한다.
↓
OUTPUT
결제가 완료되고 주문 정보가 정상적으로 생성된다.
개발 과정에서는 Black Box 내부의 코드와 로직을 검토할 수 있습니다.
하지만 실제 사용자에게 중요한 것은 입력(Input)에 대해 기대한 결과(Output)가 제대로 나타나는지입니다.
이를 실제 서비스 관점에서 확인하는 방법 중 하나가 블랙박스 테스트(Black-box Testing)입니다.
결국,
"코드가 정상적으로 실행된다"와
"사용자가 서비스를 문제없이 이용할 수 있다"는 같은 의미가 아닙니다.
코드는 정상인데, 실제 서비스에서는?
코드나 개별 기능이 정상이어도 실제 사용 과정에서는 다른 문제가 나타날 수 있습니다.
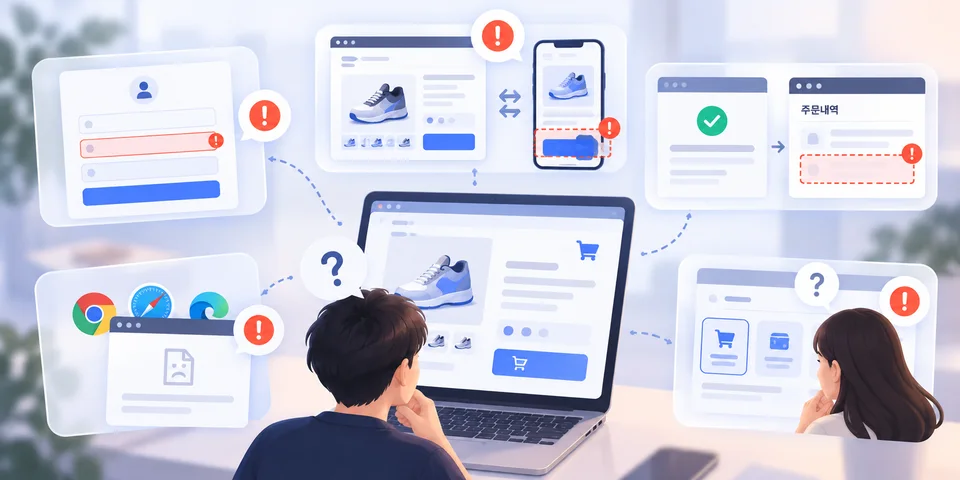
예를 들어,
회원가입은 되지만 특정 값을 입력하면 다음 단계로 넘어가지 않는다.
PC에서는 정상인데 모바일에서는 버튼이 다른 화면 요소와 겹친다.
결제는 완료됐지만 주문 내역에 반영되지 않는다.
특정 브라우저에서만 일부 기능이 작동하지 않는다.
기능은 정상인데 처음 방문한 사용자는 다음에 무엇을 해야 할지 알기 어렵다.
이런 문제는 실제 사용자가 서비스를 이용하는 흐름과 환경을 기준으로 확인해야 발견할 수 있습니다.
바이브 코딩으로 만들었다면 무엇을 확인해야 할까?
AI를 활용해 웹이나 앱을 개발했다면 출시 전 다음과 같은 항목을 확인할 수 있습니다.
확인 영역 | 확인할 내용 |
|---|---|
기능 | 로그인·회원가입·검색·결제 등 주요 기능이 정상적으로 동작하는가 |
사용자 흐름 | 가입부터 이용·결제까지 전체 과정이 끊기지 않는가 |
예외 상황 | 잘못된 입력이나 예상하지 못한 행동에도 문제가 없는가 |
사용 환경 | PC·모바일·브라우저가 달라도 정상적으로 동작하는가 |
사용성 | 처음 사용하는 사람도 기능과 화면을 쉽게 이해할 수 있는가 |
AI와 테스트 자동화는 반복적인 검증이나 코드 분석을 빠르게 수행하는 데 활용할 수 있습니다.
반면 실제 사용 과정에서 발생하는 문제나 다양한 사용자 행동, 환경에 따른 차이 등은
실제 서비스 관점에서 별도로 확인할 필요가 있습니다.
따라서 AI와 사람의 테스트는 어느 한쪽이 다른 쪽을 대신한다기보다
서로 다른 검증 영역을 보완하는 방식으로 활용할 수 있습니다.
AI로 빠르게 개발했다면, 마지막은 실제 사용자 관점에서
바이브 코딩과 AI 코딩 도구는 아이디어를 실제 서비스로 구현하는 과정을 빠르게 만들고 있습니다.
하지만 개발 방법이 달라져도 출시 전 확인해야 할 질문은 남아 있습니다.
기능은 실제로 정상 작동하는가?
사용자는 처음부터 끝까지 문제없이 이용할 수 있는가?
실제 사용 환경에서도 같은 결과가 나타나는가?
티어시(TASSI)는 웹·앱 등 소프트웨어를 대상으로 실제 사용자 관점에서
기능과 이용 과정에서 발생할 수 있는 문제를 확인하는 소프트웨어 QA·테스트 서비스입니다.
AI·바이브 코딩으로 서비스를 빠르게 만들었거나,
내부에 별도의 QA 인력이 없어 출시 전 검증이 필요하다면
필요한 범위에 맞춰 소프트웨어 테스트를 진행할 수 있습니다.
AI로 빠르게 개발했다면, 출시 전에는 사람이 사용할 준비가 되었는지도 확인해보세요.
바이브 코딩·AI 개발 테스트 FAQ
Q. 바이브 코딩으로 만든 서비스도 QA가 필요한가요?
: AI가 생성한 코드가 정상적으로 실행되더라도 사용자 행동, 실행 환경, 기능 간 연결에 따라 문제가 발생할 수 있습니다. 따라서 출시 전 실제 사용 흐름을 기준으로 주요 기능을 확인할 필요가 있습니다.
Q. AI 테스트와 사람의 테스트는 무엇이 다른가요?
: AI와 자동화는 코드 분석이나 반복적인 검증에 활용할 수 있습니다. 사람의 테스트는 실제 사용자 흐름, 다양한 환경과 행동, 사용성 등 서비스 이용 관점에서 문제를 확인하는 데 활용할 수 있습니다.
Q. 티어시(TASSI)는 무엇인가요?
: 티어시(TASSI)는 필요한 시점과 범위에 맞춰 전문 QA 서비스를 이용할 수 있는 구독형 소프트웨어 품질보증 서비스입니다. 웹·앱 등 소프트웨어의 기능과 사용성을 실제 사용자 관점에서 검증하고, 테스트 결과를 리포트로 제공합니다.
참고자료
Stack Overflow, 2025 Developer Survey – AI